По данным совместного исследования Google и Deloitte «Milliseconds Make Millions», задержка загрузки мобильного сайта на 100 миллисекунд снижает конверсию на 8%. Схожую закономерность фиксировали и специалисты Akamai: двухсекундная задержка увеличивает показатель отказов вдвое, а каждая дополнительная секунда ожидания уменьшает конверсию ещё на 7%. Когда сервис падает именно в пиковый момент — во время распродажи, вирусного поста или выхода ТВ-рекламы — потери многократно выше: платящие пользователи уходят, не завершив заказ, SLA-штрафы начисляются автоматически, а репутационный ущерб отыграть куда сложнее, чем технический инцидент. Предотвратить этот сценарий помогает нагрузочное тестирование сайта — систематическая проверка того, как ведёт себя система под реальным и пиковым потоком запросов, ещё до того, как к ней пришли живые пользователи.
TL;DR: нагрузочное тестирование сайта показывает, сколько пользователей система выдержит без деградации, и где находится точка отказа. На сервис подают контролируемый поток виртуальных пользователей (k6, JMeter, Gatling, Yandex.Tank) и фиксируют время отклика, error rate и потребление ресурсов. Тестировать нужно за 4–6 недель до пика — этого времени хватает, чтобы найти и исправить типичные узкие места: медленные запросы к БД, нехватку кэша, тесный пул соединений.
Что такое нагрузочное тестирование сайта простыми словами
Нагрузочное тестирование сайта — это вид нефункционального тестирования, при котором на систему подаётся контролируемый поток виртуальных пользователей, а инструменты фиксируют, как меняются время отклика, количество ошибок и потребление ресурсов по мере роста нагрузки.
Важно сразу разграничить его с функциональным тестированием. Функциональное проверяет «работает ли фича правильно»: кнопка добавления в корзину сохраняет товар, форма валидирует e-mail, API возвращает корректный JSON. Нагрузочное же спрашивает совсем другое: «выдержит ли система N пользователей одновременно, и что произойдёт при N×3?». Обе проверки необходимы, но ни одна не заменяет другую.
Для владельца продукта или технического директора нагрузочное тестирование — это инструмент управления рисками. Оно даёт ответы на три практических вопроса: какую нагрузку система выдерживает сейчас, где находится точка деградации, и что нужно изменить, чтобы выдержать прогнозируемый пик.
Зачем бизнесу нагрузочное тестирование
Риски отказа под пиком
Трафиковые пики бывают разными по происхождению, но одинаково опасными для неподготовленных систем:
- Сезонные и маркетинговые. Чёрная пятница, 11.11, новогодние распродажи, старт сезона. Трафик может вырасти в 5–20 раз за считанные минуты.
- Рекламные запуски. ТВ-ролик, публикация у крупного блогера или пресс-релиз на федеральном СМИ создают мгновенный наплыв аудитории, которая не будет ждать загрузки сайта.
- Вирусный трафик. Непредсказуем по времени. Пост в соцсетях или новость могут привести тысячи пользователей одновременно без какого-либо предупреждения.
- Миграции и крупные релизы. Переход на новую инфраструктуру или значимое обновление — момент повышенного риска, особенно если изменилась архитектура работы с базой данных.
Цена простоя: упущенная выручка, отток и SLA-штрафы
По оценкам Gartner, средняя стоимость простоя критичных систем превышает $5 600 в минуту для корпоративного сектора, а для интернет-магазина в пиковые часы цифра может быть сопоставимой. Но прямые потери — лишь часть ущерба. Пользователь, столкнувшийся с ошибкой 503 в момент покупки, с высокой вероятностью уйдёт к конкуренту и не вернётся. Если сервис работает по SLA с корпоративными клиентами, недоступность сверх порога влечёт финансовые штрафы, прописанные в договоре.
Когда пора тестировать
Нагрузочное тестирование нужно планировать в нескольких ситуациях:
- Перед запуском нового сервиса или крупной функциональности в продакшн.
- За 4–6 недель до ожидаемого пика (распродажа, сезон, маркетинговая акция) — чтобы оставалось время на оптимизацию.
- После серьёзного рефакторинга, смены ORM, миграции баз данных или перехода на новую инфраструктуру.
- При кратном росте аудитории: если DAU вырос в 3–5 раз, профиль нагрузки изменился, и старые результаты тестов перестали быть актуальными.
Виды нагрузочного тестирования
«Нагрузочное тестирование» — зонтичный термин. На практике различают несколько типов, каждый из которых решает свою задачу:
| Тип | Цель | Когда применять |
|---|---|---|
| Load (нагрузочный) | Проверить поведение при ожидаемой рабочей нагрузке | Базовое тестирование перед запуском и релизами |
| Stress (стрессовый) | Найти точку отказа — максимум, после которого система ломается | Выявление абсолютного предела мощности |
| Spike (пиковый) | Проверить реакцию на резкий скачок трафика | Подготовка к маркетинговым акциям и ТВ-рекламе |
| Soak / Endurance (на выносливость) | Обнаружить утечки памяти и деградацию за долгое время | Проверка стабильности при длительной работе |
| Scalability / Volume (масштабируемость) | Понять, как система справляется с ростом данных | Планирование горизонтального масштабирования |
Load — проверка на ожидаемой нагрузке
Классический вариант: на систему подаётся нагрузка, равная прогнозируемому рабочему трафику, и фиксируется, укладываются ли время отклика и error rate в приемлемые пороги. Обычно это baseline-тест, который проводят первым.
Stress — поиск точки отказа
Нагрузку планомерно увеличивают сверх нормы до тех пор, пока система не начнёт деградировать или падать. Цель — не сломать систему ради разрушения, а понять, каков реальный запас прочности и как именно она отказывает: gracefully (с понятными ошибками) или catastrofically (данные теряются, процессы зависают).
Spike — резкий скачок трафика
Имитирует ситуацию, когда за секунды трафик вырастает в 10 раз, а затем резко падает. Типично для сценария «вышел ролик на ТВ» или «известный блогер опубликовал ссылку». Проверяется, как быстро система восстанавливается после пика и не остаётся ли она в деградированном состоянии.
Soak / Endurance — тест на выносливость
Система работает под средней нагрузкой долгое время — от нескольких часов до нескольких суток. Задача — обнаружить утечки памяти, накопительные ошибки (например, исчерпание пула соединений к БД) и постепенную деградацию производительности, которые не видны в кратких прогонах.
Scalability / Volume — рост данных и масштабирование
Тестирует поведение системы при увеличении объёма данных: как замедляется запрос, когда таблица выросла с миллиона до миллиарда записей; как ведёт себя поиск при удвоении индекса. Особенно важен для сервисов с быстро растущей базой пользователей или контента.
Ключевые метрики: что и как измеряют
Результат нагрузочного теста — это не одно число, а набор метрик, которые вместе рассказывают историю о том, что происходит с системой. Вот основные из них:
- RPS / Throughput (запросов в секунду). Сколько запросов система обрабатывает в единицу времени. Растёт линейно до точки насыщения, после которой перестаёт расти или начинает падать.
- Latency: p50, p95, p99. Время отклика в процентилях. p50 — медианное время, которое получает половина пользователей; p99 — то, что получают самые «медленные» 1%. Именно p99 важен для бизнеса: SLA обычно задаётся по нему, и именно медленные запросы видят VIP-клиенты.
- Error Rate (доля ошибок). Процент запросов, завершившихся ошибкой (5xx, таймаут, разрыв соединения). Порог приемлемости зависит от бизнеса: для платёжного шлюза допустимо 0%, для аналитического дашборда — может быть и 0,1%.
- Concurrency / VU (виртуальные пользователи). Количество одновременно активных пользователей, которые инструмент эмулирует в данный момент.
- Утилизация ресурсов. CPU, RAM, I/O дисков, пропускная способность сети — что именно становится узким местом при росте нагрузки.
- Точка насыщения (saturation point). Момент, когда увеличение числа пользователей перестаёт давать прирост throughput, а latency начинает расти. Это граница между «работает нормально» и «работает с деградацией».
Как читать отчёт нагрузочного теста
Хороший отчёт показывает все метрики в динамике — как они менялись по мере роста нагрузки, а не только итоговое среднее. Смотрите на три вещи: при какой нагрузке начал расти p99; при каком числе VU появились первые ошибки; какой ресурс упёрся в потолок первым (CPU, RAM, БД или внешний API). Это и есть ваше узкое место.
Инструменты нагрузочного тестирования
Выбор инструмента влияет на удобство написания сценариев, масштаб теста и читаемость отчётов. Основные варианты:
| Инструмент | Язык сценариев | Сильные стороны |
|---|---|---|
| k6 | JavaScript (ES6+) | Низкое потребление ресурсов, удобный CLI, встроенная интеграция с Grafana и CI/CD |
| Apache JMeter | GUI + XML / Groovy | Огромная экосистема плагинов, поддержка множества протоколов, наглядный GUI |
| Gatling | Scala / Java | Высокая производительность, удобные HTML-отчёты, Code-first подход |
| Locust | Python | Простота написания сценариев, распределённый режим, низкий порог входа |
| Yandex.Tank | YAML / Python | Оптимизирован под российский стек, интеграция с Overload (облачный сервис аналитики) |
| Artillery | YAML / JavaScript | Простой старт, хорошая поддержка WebSocket и GraphQL |
На практике выбор чаще всего сводится к k6 (если команда пишет на JavaScript и нужна интеграция с CI), JMeter (если в команде есть опытные тестировщики с GUI-инструментами) или Yandex.Tank (для сервисов, развёрнутых в российской инфраструктуре с упором на детальную аналитику). Locust удобен, когда автоматизаторы сильнее в Python, чем в JS.
Как выбрать инструмент под ваш стек и команду
Если формальных ограничений нет, отталкивайтесь не от популярности инструмента, а от трёх практических вопросов:
- На чём команда пишет автотесты сейчас? Если в проекте уже есть JS/TS-автоматизация — k6 встроится в неё без переключения контекста. Python-автоматизаторам естественнее взять Locust.
- Нужен ли GUI для нетехнических участников? Если сценарии составляет тестировщик без опыта кодирования, JMeter с его визуальным конструктором снижает порог входа — ценой более громоздких XML-файлов сценариев.
- Где хостится инфраструктура и нужна ли локальная поддержка? Для российских дата-центров и требований к хранению данных внутри контура Yandex.Tank с Overload остаётся самым проработанным вариантом с готовой облачной аналитикой.
- Насколько сложны сценарии? WebSocket, GraphQL или множественные протоколы в одном сценарии — сильная сторона Artillery и Gatling; для простого HTTP/REST-нагрузочного теста любой из шести инструментов справится одинаково хорошо.
Для большинства веб-проектов на типовом стеке (REST API + SPA/SSR-фронтенд) k6 — самый быстрый способ получить первые результаты: минимальная кривая обучения, читаемые пороги (thresholds) прямо в сценарии и нативная интеграция с GitLab CI/GitHub Actions.
Кто участвует в нагрузочном тестировании: роли и зона ответственности
Нагрузочное тестирование редко делает один человек «между делом» — даже базовый прогон требует согласованной работы нескольких ролей:
- Performance/QA-инженер. Формулирует профиль нагрузки, пишет сценарии, запускает тесты, снимает и интерпретирует метрики. Основной исполнитель всего цикла.
- DevOps/SRE-инженер. Готовит тестовый стенд, идентичный продакшену по конфигурации, настраивает мониторинг (CPU, RAM, I/O, пул соединений) и параллельно с тестом следит за инфраструктурой в реальном времени.
- Backend-разработчик. Разбирает найденные узкие места — медленные запросы, N+1, блокировки — и вносит правки в код. Без него отчёт с метриками остаётся просто отчётом.
- DBA или инженер по базам данных. Нужен, если узкое место оказывается на стороне СУБД: анализ планов запросов, настройка индексов, тюнинг пула соединений — задачи, которые редко входят в компетенцию фронтенд- или бэкенд-разработчика.
- Product owner / бизнес-заказчик. Задаёт целевые значения («держим 5 000 VU с p99 не выше 800 мс») исходя из бизнес-контекста — маркетингового плана, исторической аналитики трафика, SLA с клиентами. Без этого участия тест проводится «в вакууме», без критерия успеха.
Для разового теста перед конкретным запуском эти роли можно закрыть силами 1–2 специалистов с широким профилем. Для регулярного нагрузочного тестирования в составе CI/CD пайплайна нужен постоянный владелец процесса — иначе тесты быстро устаревают и перестают отражать реальный профиль трафика.
Как подготовить сервис к пиковой нагрузке: пошагово
Шаг 1. Определить цели и профиль нагрузки
Начните не с инструмента, а с вопросов к бизнесу: какой пиковый онлайн ожидается и когда? Сколько RPS генерирует один пользователь в каждом сценарии? Какие сценарии критичны — оформление заказа, авторизация, поиск? Без чётких целей тест превращается в «гоним трафик и смотрим, что будет», а это редко приводит к полезным выводам. Зафиксируйте целевые значения: «система должна держать 5 000 VU с p99 latency не более 800 мс и error rate ниже 0,5%».
Как рассчитать целевое число VU. Базовая формула: возьмите реальный или прогнозируемый пиковый онлайн (из Google Analytics/Яндекс.Метрики за прошлый сезонный пик, если он был, или из плана маркетинговой кампании) и умножьте на коэффициент запаса 1,5–3×. Например, если в прошлую Чёрную пятницу одновременный онлайн достигал 2 000 пользователей, а в этот раз ожидается рост аудитории на треть, целевая цифра — (2 000 × 1,33) × 2 ≈ 5 300 VU. Дополнительно поверх целевой нагрузки проводят stress-тест до точки отказа — чтобы знать не только «выдержит ли систему план», но и реальный запас прочности на случай, если прогноз окажется консервативным.
Шаг 2. Подготовить тестовое окружение и данные
Идеальный staging — зеркало продакшена по конфигурации: те же CPU/RAM, та же СУБД с сопоставимым объёмом данных, те же кэши. Тест на слабом стенде даст цифры, которые ничего не скажут о реальном поведении. Реалистичные тестовые данные критичны: запрос к пустой таблице и к таблице с 50 миллионами записей работают принципиально по-разному.
Шаг 3. Написать сценарии
Сценарий — это последовательность действий, которую совершает виртуальный пользователь: открыть главную, войти в аккаунт, поискать товар, добавить в корзину, оформить заказ. Важно охватить не один «золотой путь», а реальное распределение: из 1 000 пользователей, пришедших на главную, 300 ищут товар, 100 идут в корзину, 30 оформляют заказ. Такое распределение называется профилем нагрузки, и он должен отражать реальную аналитику, а не фантазии.
Шаг 4. Прогнать тесты и снять метрики
Начните с baseline: 10–20% от целевой нагрузки. Зафиксируйте метрики в нормальных условиях — это точка отсчёта. Затем ступенчато увеличивайте нагрузку, давая системе стабилизироваться на каждой ступени. Параллельно мониторьте сервер: CPU, RAM, I/O, пул соединений к БД, очереди. Все данные собирайте в одном таймлайне — это облегчит корреляцию «нагрузка выросла → что именно деградировало».
Шаг 5. Найти узкие места
Типичные виновники деградации под нагрузкой:
- Медленные запросы к БД. N+1 запросы, отсутствующие индексы, полное сканирование таблиц — всё это незаметно при единичных пользователях и убивает систему при тысячах.
- Исчерпание пула соединений. Если пул к PostgreSQL настроен на 100 соединений, а в пике приходит 500 VU — очередь нарастает, latency взлетает.
- Блокировки и дедлоки. Конкурентные операции записи без правильной транзакционной логики приводят к блокировкам, которые при нагрузке становятся катастрофой.
- Отсутствие кэша. Каждый запрос идёт в БД вместо того, чтобы брать данные из Redis — это многократно увеличивает нагрузку на базу.
- Медленные внешние API. Платёжный шлюз или SMS-сервис, который отвечает за 3 секунды, становится узким местом всего флоу при росте нагрузки.
Шаг 6. Оптимизировать и масштабировать
После обнаружения узких мест следует итерация оптимизации. Типичные меры:
- Добавить индексы к «горячим» запросам БД, переписать N+1 через JOIN или prefetch.
- Настроить кэширование (Redis / Memcached) для часто читаемых данных.
- Вынести тяжёлые операции (email-рассылка, генерация PDF, импорт данных) в асинхронные очереди (RabbitMQ, Kafka).
- Настроить CDN для статики и медиафайлов — чтобы снять нагрузку с origin-серверов.
- Перейти на горизонтальное масштабирование: добавить реплики приложения за балансировщиком нагрузки.
- Настроить автоскейлинг в облаке, чтобы при скачке трафика инфраструктура поднималась автоматически. Именно здесь часто нужна помощь с настройкой инфраструктуры и автоскейлинга — без опыта в DevOps конфигурация авто-масштабирования легко превращается в источник проблем.
Шаг 7. Повторить и внедрить в CI/CD
После каждого раунда оптимизации нужен повторный прогон — чтобы убедиться, что метрики улучшились, и не появился регресс в другом месте. В идеале нагрузочные тесты становятся частью пайплайна: небольшой smoke-load-test после каждого деплоя позволяет поймать деградацию производительности ещё до того, как она попадёт в продакшн. Это называется «регресс производительности», и его отсутствие — одна из самых частых причин, по которым системы деградируют незаметно.
Пример: как нагрузочное тестирование раскрывает узкое место
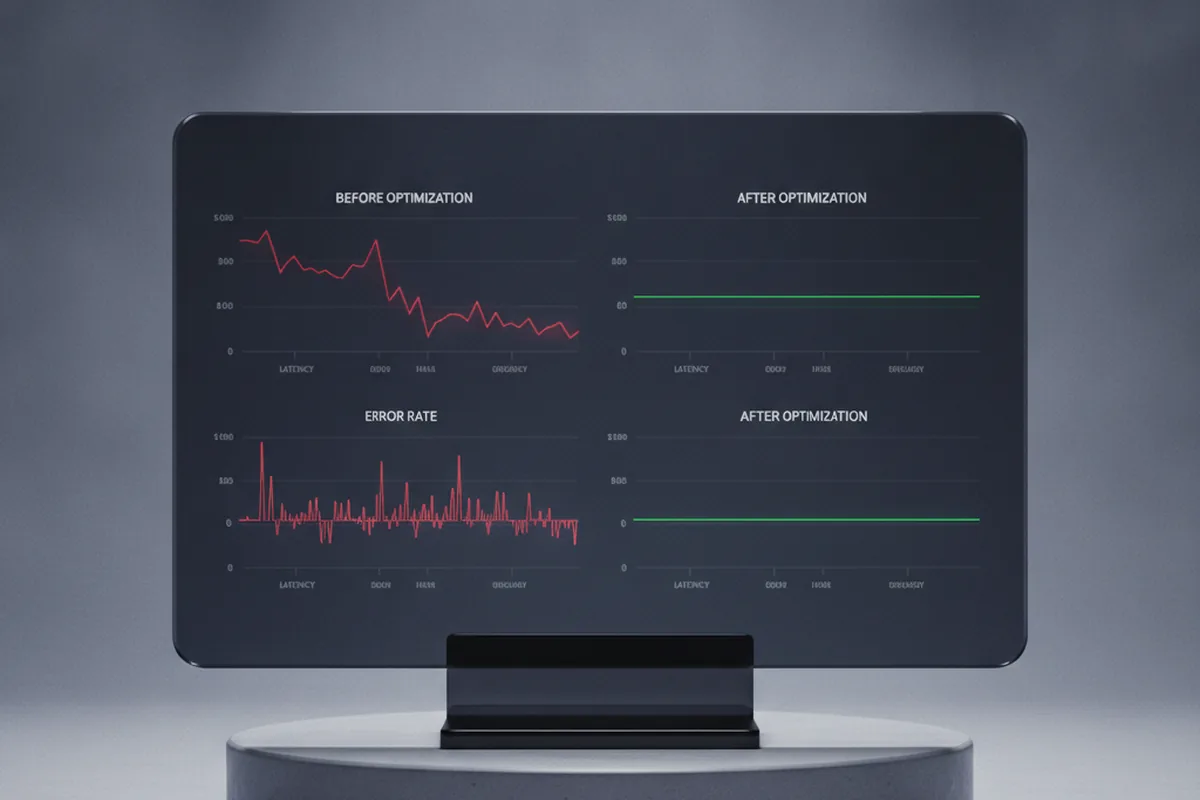
Типичный сценарий выглядит так. Интернет-магазин планирует распродажу и заказывает нагрузочное тестирование страницы каталога и оформления заказа. Baseline-прогон на 200 VU проходит гладко: p95 latency — 320 мс, error rate — 0%. Дальше нагрузку поднимают ступенчато.
| Метрика | При 200 VU | При 1 500 VU (до фикса) | При 1 500 VU (после фикса) |
|---|---|---|---|
| p95 latency | 320 мс | 6 400 мс | 410 мс |
| Error rate | 0% | 18% | 0,2% |
| Throughput (RPS) | 140 | 310 (плато) | 980 |
При 1 500 VU throughput перестаёт расти («упирается в потолок» на отметке ~310 RPS), а p95 latency улетает за 6 секунд — классический признак точки насыщения. Мониторинг сервера в этот момент показывает, что CPU и RAM в норме, а вот пул соединений к PostgreSQL исчерпан полностью: запросы к странице каталога делают N+1 обращение к таблице остатков на складе — по одному SELECT на каждую карточку товара в выдаче.
Исправление — заменить N+1 на один JOIN-запрос и добавить композитный индекс по паре «товар + склад». После повторного прогона на тех же 1 500 VU throughput вырастает более чем втрое, p95 latency возвращается к комфортным 410 мс, а error rate падает с 18% до 0,2% (это уже единичные таймауты внешнего API проверки остатков, а не проблема самого сервиса). Именно так нагрузочное тестирование окупает себя: узкое место, которое проявилось бы только в реальную распродажу и стоило бы упущенной выручки, находят и чинят заранее, на тестовом стенде.
Типичные ошибки при нагрузочном тестировании
- Тест на маломощном стенде. Если staging в 10 раз слабее продакшена, результаты не переносятся. Тест покажет красивые цифры, а на проде случится катастрофа.
- Нереалистичные сценарии. «Все пользователи одновременно жмут одну кнопку» — не сценарий. Реальный профиль нагрузки берётся из аналитики, а не из фантазии.
- Игнорирование p99. Среднее время отклика в 200 мс выглядит хорошо, но если p99 = 8 секунд, каждый сотый пользователь получает ужасный опыт. Этот каждый сотый — возможно, ваш лучший клиент.
- Разовость вместо регулярности. Провести тест один раз перед запуском и больше никогда — значит не знать, что происходит с системой после каждого обновления. Деградация накапливается постепенно.
- Тест только сервера без учёта внешних зависимостей. Если не мокировать медленный внешний API, тест покажет его узким местом, а не ваш код. Если мокировать всё — пропустите реальные ограничения интеграций.
Стоимость и сроки
Стоимость нагрузочного тестирования зависит от нескольких факторов:
- Сложность и количество сценариев. Один критичный путь (авторизация → оплата) — это одна трудоёмкость; полный набор из 15–20 сценариев с реалистичным распределением — другая.
- Требования к окружению. Нужно ли поднимать отдельный staging, идентичный продакшену? Оплачивать облачные ресурсы для генерации нагрузки от тысяч VU?
- Тип тестов. Базовый load-тест дешевле, чем soak-тест на 48 часов или полный цикл stress + spike + endurance.
- Глубина анализа. Простой отчёт «вот метрики» или детальный разбор узких мест с рекомендациями по оптимизации — это разные объёмы работы.
Условно: базовое нагрузочное тестирование одного сервиса с 3–5 сценариями и отчётом — от нескольких дней работы специалиста. Полный цикл с оптимизацией и повторными прогонами — недели. Если вам нужна оценка конкретно под ваш проект, посмотрите на нашу услугу нагрузочное тестирование под ключ — мы составляем смету после брифа, без навязывания лишних работ.
Чек-лист готовности к нагрузочному тестированию
Перед первым прогоном пройдитесь по короткому чек-листу — большинство «бесполезных» тестов проваливаются именно на этих пунктах:
- Целевые значения зафиксированы письменно: конкретное число VU/RPS, порог p95/p99 latency и допустимый error rate — а не «протестируем и посмотрим».
- Тестовый стенд по конфигурации (CPU, RAM, версии СУБД, кэши) сопоставим с продакшеном — иначе цифры не перенесутся на реальную систему.
- Тестовые данные реалистичны по объёму: таблицы заполнены сопоставимо с продакшеном, а не пустые.
- Сценарии отражают реальное распределение действий пользователей из аналитики, а не один «золотой путь».
- Мониторинг сервера (CPU, RAM, I/O, пул соединений к БД, очереди) настроен и пишет метрики в тот же таймлайн, что и результаты теста.
- Внешние зависимости (платёжный шлюз, SMS, сторонние API) осознанно замоканы или, наоборот, включены в тест — решение принято, а не забыто.
- Команда и заказчик знают дату и окно теста: нагрузочный тест на живой продакшн без предупреждения — источник ложных инцидентов у дежурных.
- Есть план отката/остановки теста, если стенд ведёт себя нештатно (например, тест случайно направлен не на staging).
Частые вопросы (FAQ)
Чем нагрузочное тестирование отличается от функционального?
Функциональное тестирование проверяет, работает ли фича правильно. Нагрузочное проверяет, выдержит ли система заданное количество одновременных пользователей — и как изменится время отклика, ошибки и стабильность при росте нагрузки.
Когда нужно заказывать нагрузочное тестирование?
Перед крупным запуском или рекламной акцией, после серьёзного рефакторинга и смены архитектуры, при кратном росте аудитории, перед миграцией инфраструктуры или переходом на новый хостинг.
Какие инструменты используют для нагрузочного тестирования?
Наиболее распространены k6, Apache JMeter, Gatling, Locust, Yandex.Tank (для российских сервисов) и Artillery. Выбор зависит от стека, навыков команды и сложности сценариев.
Сколько пользователей нужно эмулировать?
Ориентир — реальный или прогнозируемый пиковый онлайн, умноженный на коэффициент запаса 1,5–3×. Дополнительно проводят стресс-тест до точки отказа, чтобы понять реальный предел системы.
Как часто проводить нагрузочное тестирование?
Минимум — перед каждым значимым релизом и сезонным пиком. Оптимально — встроить автоматические прогоны в CI/CD как регресс производительности, чтобы деградация обнаруживалась сразу после каждого деплоя.
Своей командой или через подрядчика?
Если в штате есть performance-инженер и DevOps с опытом настройки стендов — тест можно провести своими силами. Если такой компетенции нет или тест разовый (перед конкретным запуском), быстрее и дешевле привлечь подрядчика: не нужно закупать лицензии и держать специалиста в штате ради нескольких прогонов в год.
Сколько стоит нагрузочное тестирование сайта?
Базовый тест одного сервиса с 3–5 сценариями и отчётом — от нескольких дней работы специалиста. Итоговая стоимость зависит от числа сценариев, требований к тестовому стенду, типа тестов (load / stress / spike / soak) и глубины анализа узких мест — точную смету считают после брифа.
Готовите сервис к пиковой нагрузке?
Проведём нагрузочное тестирование, найдём узкие места и поможем сервису выдержать пик без падений и потери выручки.