TL;DR. PostgreSQL поддерживает шесть типов индексов — B-Tree, Hash, GiST, SP-GiST, GIN и BRIN, каждый под свою задачу: от точного совпадения до полнотекстового поиска. В отличие от SQL Server и MySQL, постоянного «кластерного индекса» здесь нет: таблица хранится как неупорядоченная куча (heap), а физическую переупорядочку по индексу выполняет разовая команда CLUSTER. Разбираем типы, классы, синтаксис CREATE INDEX и случаи, когда индекс не ускоряет запрос, а замедляет запись.
PostgreSQL — популярная реляционная система управления базами данных. Чтобы запросы к большим таблицам не превращались в полное сканирование, используют индексы в базах данных (далее в тексте — БД) — отдельные структуры, которые хранят значение столбца и TID (указатель на строку в таблице), а не сами данные. Ниже рассмотрим все типы индексов SQL в PostgreSQL и покажем, как их применять на практике.
В блоге студии web-разработки YuSMP Group пишем на различные темы, которые относятся к разработке. Статьи будут интересны как специалистам, так и тем, кто только знакомится с IT.
Подбор индексов и оптимизация запросов к БД — часть разработки backend и API на заказ в YuSMP Group: мы проектируем структуру базы данных под реальную нагрузку проекта, а не по шаблону.
Индекс: это что такое и зачем он нужен
Индекс — объект базы данных, который играет ключевую роль в обеспечении эффективной работы с информацией. Его предназначение — ускорение операций поиска, сортировки и фильтрации, что критически важно при работе с большими таблицами.
Индекс — это дополнительная структура, которая хранит значения столбца (или набора столбцов) и TID — указатель на физическое место строки в таблице. Найдя нужное значение в индексе, PostgreSQL сразу переходит по TID к строке в таблице, вместо того чтобы читать её целиком с диска. Это позволяет избежать полного сканирования таблицы (Seq Scan) и сокращает количество операций ввода-вывода.
Как работают индексы: от создания до использования в запросах
Создание
Индекс создаётся на одном или нескольких столбцах таблицы командой CREATE INDEX. При создании PostgreSQL анализирует значения столбца и строит структуру, обеспечивающую быстрый доступ к записям с этими значениями. Процесс может быть явным (разработчик выполняет CREATE INDEX) или неявным — индекс автоматически создаётся для PRIMARY KEY и UNIQUE-ограничений.
Структура
Индексы реализуются разными структурами данных — B-дерево, хеш-таблица, Generalized Search Tree и другие. Каждая имеет свои особенности и подходит для конкретного типа запросов; подробно разбираем все шесть типов индексов PostgreSQL ниже.
Обновление
При вставке, обновлении или удалении строк таблицы все индексы, построенные на изменённых столбцах, обновляются автоматически — PostgreSQL берёт эту работу на себя, чтобы гарантировать согласованность индекса с данными в таблице. Именно поэтому индексы не бесплатны: чем больше индексов на таблице, тем дороже становится запись.
Использование в запросах
Планировщик запросов PostgreSQL использует информацию о существующих индексах при построении плана выполнения. Он анализирует структуру запроса, оценивает селективность условий и статистику таблицы (собранную ANALYZE), а затем выбирает индекс, последовательное сканирование или их комбинацию — то, что даст меньшую расчётную стоимость выполнения.
Какие операторы поддерживают индексы
Индексы ускоряют разные типы операций: точное совпадение значений (оператор «=»), поиск по диапазону (операторы «<», «>», «<=», «>=»), частичное совпадение (например, оператор LIKE PostgreSQL с якорным префиксом), а также сортировку (ORDER BY). Какой именно оператор поддерживает конкретный индекс, зависит от его типа — не любой postgres indexes одинаково хорош для любой операции.
Шесть типов индексов PostgreSQL
В PostgreSQL есть шесть встроенных типов индексов, и у каждого — своя специализация. Ниже сводная таблица, а после неё — разбор по каждому типу.
| Тип | Для чего | Основные операторы | Пример применения |
|---|---|---|---|
| B-Tree | Универсальный, тип по умолчанию | =, <, <=, >=, >, BETWEEN, LIKE 'abc%' | Поиск по id, email, дате |
| Hash | Только точное совпадение | = | Редко используется отдельно от B-Tree |
| GiST | Геометрия, диапазоны, ближайший сосед | &&, <->, @> | PostGIS, диапазонные типы данных |
| SP-GiST | Неоднородные структуры данных | <<, >>, ~ | IP-адреса, префиксные деревья |
| GIN | Составные значения: массивы, JSONB | @>, ?, ?&, ?|, @@ | Полнотекстовый поиск, фильтры по JSONB |
| BRIN | Огромные таблицы с естественным порядком | =, <, <=, >=, > | Таблицы логов, партиции по дате |
B-дерево (B-Tree)
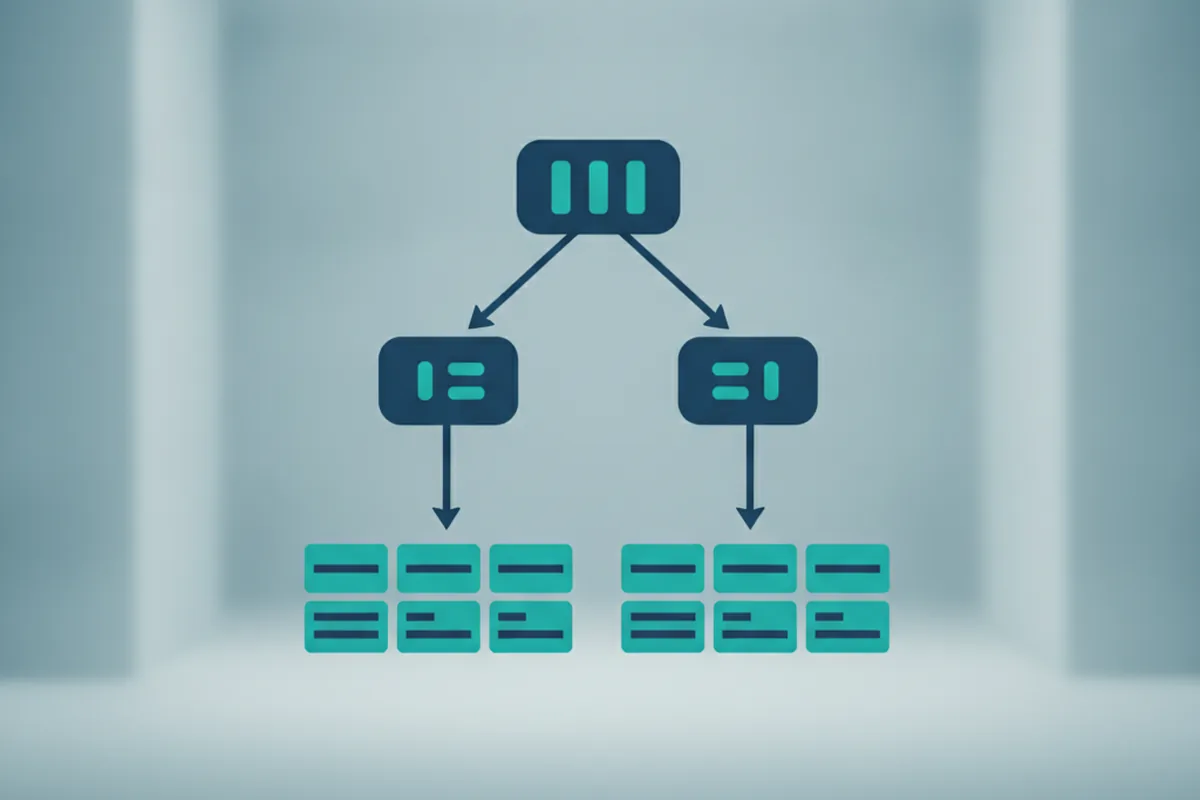
Наиболее распространённый тип в PostgreSQL и индекс по умолчанию для команды CREATE INDEX без явного указания типа. Поддерживает быстрый поиск и сортировку данных, подходит для равенства, диапазонного и частичного совпадения (оператор LIKE PostgreSQL с якорным префиксом). B-Tree можно создать на одном или нескольких столбцах.
Хеш (Hash)
Использует хеш-функцию для определения местоположения записей. Обеспечивает быстрый доступ к данным при точном совпадении (оператор «=»), но не поддерживает поиск по диапазону или частичное совпадение. На практике применяется реже B-Tree: с современных версий PostgreSQL хеш-индексы журналируются (WAL-logged) и безопасны для репликации, но по функциональности всё ещё уступают B-Tree, который справляется с равенством не хуже.
GiST (Generalized Search Tree)
Обобщённая инфраструктура поиска, которая позволяет определять местоположение на основе произвольных условий, а не только точного совпадения. Используется для географических данных (PostGIS), диапазонных типов и поиска «ближайшего соседа» — например, найти пять ближайших точек к заданным координатам.
SP-GiST (Space-Partitioned GiST)
Родственник GiST, оптимизированный под неоднородные (не сбалансированные) структуры данных — квадродеревья, k-мерные деревья, префиксные деревья. Хорошо подходит для данных с неравномерным распределением: IP-адресов, телефонных префиксов, иерархических идентификаторов.
GIN (Generalized Inverted Index)
Обратный индекс: индексирует не значение столбца целиком, а каждый его элемент — поэтому эффективен для полнотекстового поиска, а также для массивов и JSONB, где нужно искать конкретные вхождения внутри составного значения. Строится медленнее и занимает больше места, чем B-Tree, но при частых обновлениях можно использовать GIN с fastupdate для ускорения записи.
BRIN (Block Range Index)
Хранит не значения каждой строки, а сводную информацию (min/max) по блокам физически последовательных страниц таблицы. Занимает на порядки меньше места, чем B-Tree, и хорошо работает на очень больших таблицах с естественным порядком данных — например, таблица логов или события, отсортированные по времени вставки. На таблице без естественного порядка BRIN почти бесполезен.
Классы индексов и миф о «кластерном индексе» в PostgreSQL
Важная оговорка, которую часто упускают в статьях про индексы: в PostgreSQL нет постоянного «кластерного индекса» в том смысле, в каком он есть в SQL Server или MySQL/InnoDB. В этих СУБД кластерный индекс — постоянное свойство таблицы: строки физически хранятся на диске в порядке ключа. PostgreSQL устроен иначе: таблица — это heap («куча»), строки в ней размещаются в порядке вставки, без гарантии физического упорядочивания по какому-либо индексу.
Команда CLUSTER: разовая физическая переупорядочка
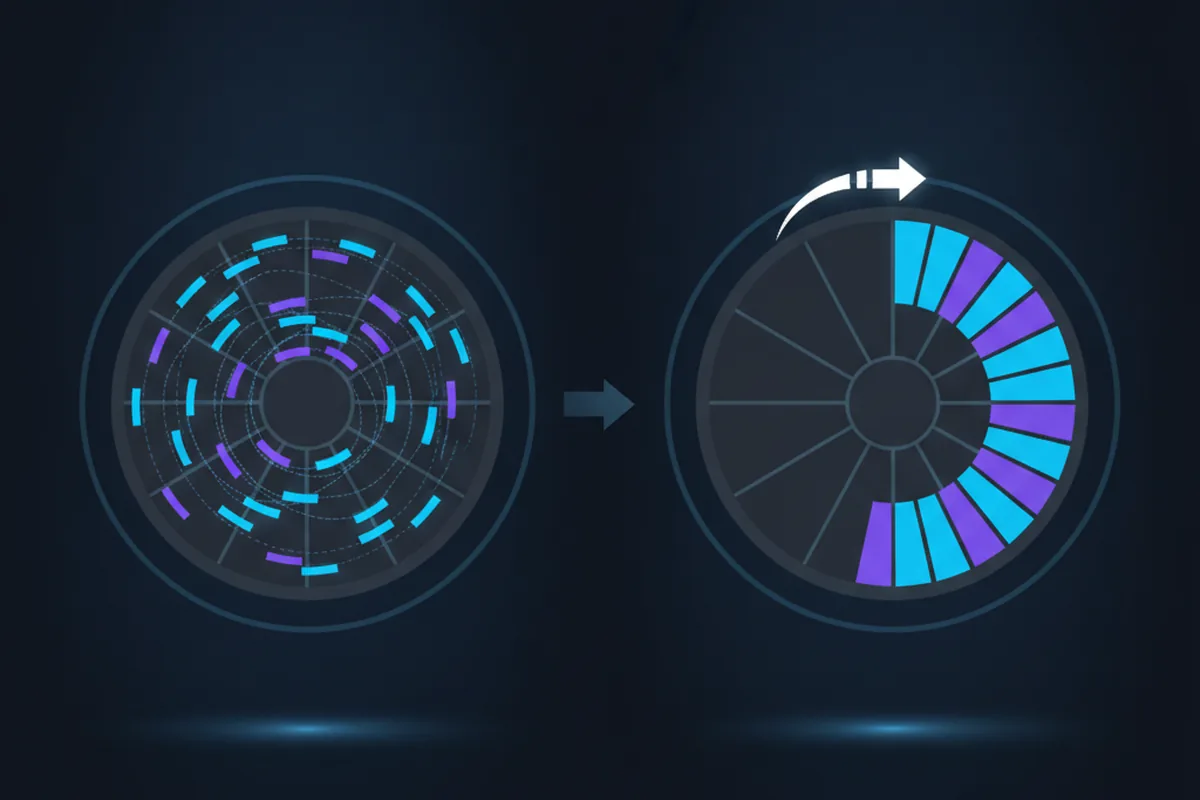
Физически переупорядочить строки таблицы на диске по индексу можно командой CLUSTER — но, в отличие от SQL Server, это не постоянное свойство таблицы, а разовая операция. После CLUSTER строки временно лежат в порядке индекса, что улучшает производительность запросов с диапазонными условиями за счёт локальности чтения. Но каждый новый INSERT и большинство UPDATE добавляют строки в произвольные блоки heap, и порядок постепенно нарушается — потребуется повторный CLUSTER. На одну таблицу можно «привязать» только один индекс для CLUSTER, и сама операция блокирует таблицу на запись, пока выполняется.
Составной индекс (Composite)
Создаётся на нескольких столбцах таблицы. Позволяет оптимизировать поиск по комбинации значений в этих столбцах и полезен, когда в запросах регулярно используются условия фильтрации или сортировки сразу по нескольким полям — например, «пользователь + дата создания заказа». Порядок столбцов в составном индексе важен: индекс на (user_id, created_at) эффективно ускорит и запрос только по user_id, и запрос по обоим полям, но не ускорит запрос только по created_at.
Пример: создаём индекс для таблицы users
Допустим, у нас есть таблица users с колонками id, name и email. Чтобы создать B-дерево (B-Tree) по столбцу email, используем такой SQL-запрос:
CREATE INDEX idx_users_email ON users USING btree (email);Этот индекс ускорит операции поиска и сортировки по полю email в таблице users. Если приложение обычно ищет пользователей по паре «email + дата регистрации», эффективнее составной индекс:
CREATE INDEX idx_users_email_created ON users (email, created_at);Когда индексы снижают производительность
Индекс — не бесплатный ускоритель, а компромисс между скоростью чтения и скоростью записи. Несколько типичных ситуаций, когда индексов становится слишком много или они работают против вас:
Избыточная запись. Каждый INSERT, UPDATE или DELETE обновляет все индексы таблицы, а не только изменённые данные. Пять индексов на активно пишущей таблице — это пять дополнительных операций записи на каждое изменение строки.
Раздувание (bloat). После массовых DELETE или частых UPDATE индекс может «раздуться»: занимать больше места и работать медленнее, даже если актуальных данных стало меньше — старые версии записей физически остаются в структуре индекса до очистки.
Неиспользуемые индексы. Индекс, который планировщик ни разу не выбрал для запроса, всё равно потребляет дисковое пространство и замедляет запись — от него стоит избавляться.
Дублирующиеся индексы. Индекс на (a, b) делает избыточным отдельный индекс на (a) — B-Tree по нескольким столбцам уже ускоряет запросы по первому столбцу композита.
Как проверить, какие индексы используются
Посмотреть все индексы таблицы можно запросом к системному представлению:
SELECT indexname, indexdef FROM pg_indexes WHERE tablename = 'users';Чтобы узнать, использует ли конкретный запрос индекс, выполните EXPLAIN ANALYZE перед ним:
EXPLAIN ANALYZE SELECT * FROM users WHERE email = 'test@example.com';В плане выполнения Index Scan или Index Only Scan означают, что PostgreSQL использует индекс; Seq Scan — что читается вся таблица целиком. Найти индексы, которые планировщик ни разу не выбрал, поможет системное представление pg_stat_user_indexes (столбец idx_scan = 0). Если индекс раздулся после массовых изменений — пересоберите его командой REINDEX (в проде — REINDEX CONCURRENTLY, чтобы не блокировать таблицу на время пересборки).
Заключение
Индексы в PostgreSQL — мощный инструмент для оптимизации производительности запросов к базе данных. Знание всех шести типов и понимание того, как PostgreSQL физически хранит данные (heap, а не постоянный кластерный индекс), позволяет найти индекс, который лучше всего подходит для конкретного сценария. Важно помнить: индексы ускоряют чтение и замедляют запись, поэтому их количество и типы нужно балансировать с реальной нагрузкой на таблицу, а не создавать «про запас».
Специалисты, которые занимаются веб-услугами и разработкой в YuSMP Group, хорошо знакомы с проектированием и оптимизацией баз данных PostgreSQL и MySQL. В стек команды входят навыки из разных областей разработки — от backend и API до PHP, JS, Java, Kotlin, Swift, Flutter и других языков.
Частые вопросы об индексах в PostgreSQL
Сколько индексов можно создать на одну таблицу в PostgreSQL?
Формального ограничения нет — можно создать десятки индексов на одну таблицу. Но у каждого есть цена: любой INSERT, UPDATE или DELETE обновляет все индексы таблицы, а не только изменённые данные. На практике оптимально 3–6 индексов на таблицу с интенсивной записью; для read-heavy таблиц (справочники, витрины) их может быть больше.
Что такое кластерный индекс в PostgreSQL — он вообще есть?
Постоянного кластерного индекса, как в SQL Server или MySQL/InnoDB, в PostgreSQL нет. Таблица хранится как heap — строки лежат в порядке вставки, без физической привязки к какому-либо индексу. Разово упорядочить строки на диске по индексу можно командой CLUSTER, но это не постоянное свойство: новые INSERT и UPDATE снова нарушают порядок.
Индекс всегда ускоряет запрос?
Нет. Индекс ускоряет выборку по условию, которое он покрывает, но замедляет запись — каждое изменение строки обновляет и индекс. Если таблица маленькая или запрос возвращает большую часть строк, планировщик PostgreSQL может выбрать последовательное сканирование (Seq Scan) как более быстрый вариант, даже при наличии подходящего индекса.
Чем B-Tree отличается от GIN?
B-Tree — индекс по умолчанию для скалярных значений: чисел, дат, строк, он ускоряет равенство, диапазоны и сортировку. GIN — обратный индекс для составных значений: массивов, JSONB и полнотекстового поиска, он индексирует не всё значение целиком, а каждый его элемент, что позволяет искать вхождения внутри массива или JSON-документа.
Как узнать, использует ли запрос индекс?
Выполните EXPLAIN ANALYZE перед запросом. В плане выполнения будет виден тип сканирования: Index Scan или Index Only Scan означают, что индекс используется, Seq Scan — что PostgreSQL читает всю таблицу целиком. Список неиспользуемых индексов можно получить запросом к системному представлению pg_stat_user_indexes.
Нужно ли пересоздавать индекс после массового удаления строк?
После массового DELETE или частых UPDATE индекс может «раздуться» (bloat) — занимать больше места и работать медленнее, даже если актуальных данных стало меньше. В таких случаях помогает REINDEX (или REINDEX CONCURRENTLY на проде, чтобы не блокировать таблицу) — он пересобирает индекс с нуля и убирает накопленный мусор.
Проекты, которые мы создали, успешно функционируют и приносят пользу владельцам: автоматизируют бизнес-процессы, развивают бренд и увеличивают прибыль. Свяжитесь с нами, чтобы получить бесплатную консультацию по проекту. Наши эксперты подробно расскажут, как из вашей идеи сделать качественный продукт на лучших условиях.
Нужны разработчики в команду?
Подберём инженеров нужного стека под ваш проект — быстрый старт.