- Биг-дата — данные такого объёма, разнообразия и скорости поступления, что традиционные СУБД и Excel с ними не справляются: нужны распределённые системы вроде Hadoop, Spark и NoSQL.
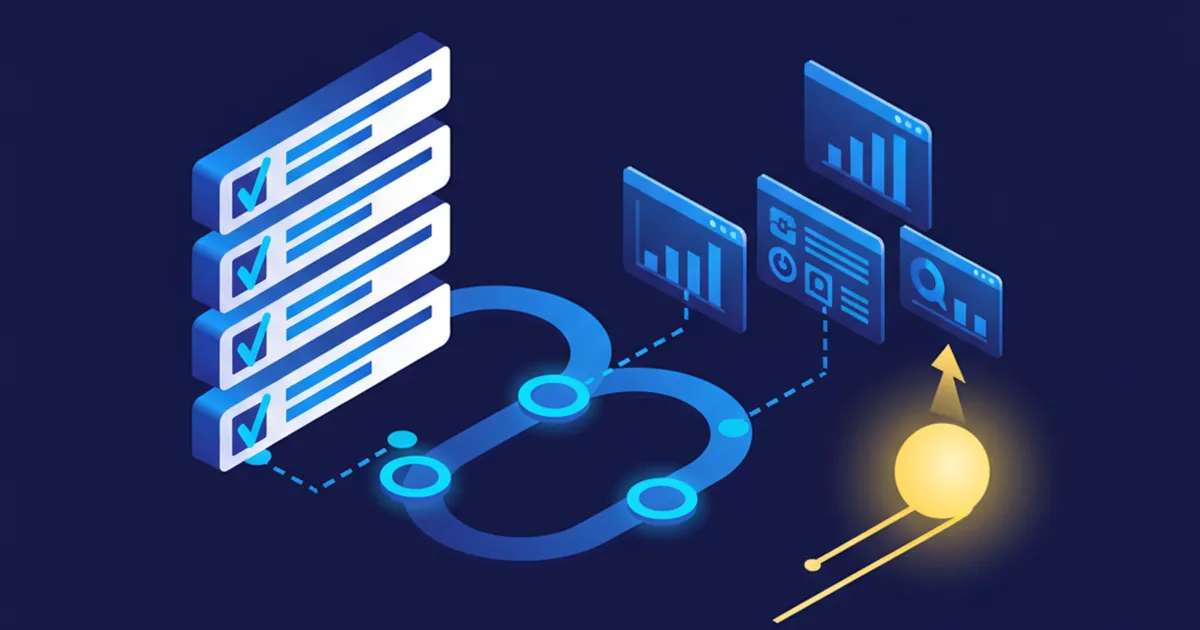
- Данные проходят конвейер «сбор → хранение → обработка → анализ» — у каждого этапа свой набор инструментов, от Kafka до ClickHouse и BI-дашбордов.
- В разработке ПО аналитика данных ускоряет поиск узких мест производительности, персонализирует интерфейс и предсказывает сбои — с примерами Netflix, Uber и Airbnb.
- Ниже — таблицы по инструментам и отраслям применения, ситуация на рынке РФ, состав команды и ответы на частые вопросы.
Современный мир, стремительно развивающийся в цифровом направлении, не мыслит своего существования без данных. Объем данных, создаваемых ежедневно, растет с невероятной скоростью, и умение работать с ними становится критически важным для всех отраслей, включая разработку программного обеспечения. Биг-дата и аналитика открывают новые горизонты для улучшения качества и функциональности программных продуктов. В этой статье мы рассмотрим, как именно данные могут помочь разработчикам и компаниям создавать более совершенные программные решения.
Если в вашем продукте уже накапливаются логи, транзакции или поведенческие метрики, но команда не успевает превращать их в решения, необязательно сразу нанимать отдельный дата-отдел — часто быстрее подключить услуги аналитики данных и BI: от настройки сбора метрик до готовых дашбордов для бизнеса.
Что такое биг-дата?
Биг-дата (Big Data) – это огромные объемы данных, которые невозможно обработать с помощью традиционных методов и инструментов. Эти данные характеризуются тремя основными параметрами: объемом, разнообразием и скоростью. Объем данных может исчисляться в петабайтах и эксабайтах, разнообразие включает текстовые файлы, изображения, видео и многое другое, а скорость подразумевает постоянный приток новых данных. В индустрии эту тройку называют моделью 3V (Volume, Variety, Velocity); позже к ней часто добавляют достоверность (Veracity) и ценность (Value) — получается расширенная модель 5V, которую используют, чтобы оценить, действительно ли конкретному проекту нужна инфраструктура биг-дата или хватит обычной базы данных.
Роль аналитики в обработке данных
Аналитика данных – это процесс исследования, очистки, трансформации и моделирования данных с целью извлечения полезной информации, поддержки принятия решений и построения выводов. В контексте разработки ПО, аналитика данных может помочь в улучшении качества продукта, оптимизации процессов разработки и повышении удовлетворенности пользователей.
По задаче аналитику делят на четыре вида — каждый следующий сложнее предыдущего и требует больше данных.
- Описательная (descriptive) — отвечает на вопрос «что произошло»: сколько было заказов, какая конверсия, где просел трафик.
- Диагностическая (diagnostic) — отвечает на «почему это произошло»: сопоставляет метрики между собой, чтобы найти причину аномалии.
- Предиктивная (predictive) — прогнозирует «что произойдёт», опираясь на исторические данные и модели машинного обучения.
- Предписывающая (prescriptive) — подсказывает «что делать»: не просто прогноз, а конкретная рекомендация к действию.
Большинство компаний начинают с описательной аналитики (дашборды и отчёты) и постепенно продвигаются к предиктивной и предписывающей — именно на этих уровнях аналитика превращается из отчётности в инструмент принятия решений.
Как собирают, хранят и обрабатывают большие данные
Прежде чем данные превращаются в отчёт или рекомендацию, они проходят через несколько последовательных этапов. Понимание этого конвейера помогает точнее сформулировать, что именно нужно автоматизировать в конкретном продукте.
- Сбор. Данные поступают из логов приложения, CRM, платёжных систем, IoT-датчиков, кликов на сайте и внешних API. Важно фиксировать не только факт события, но и контекст — время, устройство, сегмент пользователя.
- Хранение. Сырые данные складываются в data lake (например, на базе S3 или HDFS), а структурированные — в аналитическое хранилище (DWH): ClickHouse, Snowflake, BigQuery или Yandex Managed ClickHouse для проектов, ориентированных на Россию.
- Обработка. Данные очищаются от дублей и ошибок, приводятся к единому формату и агрегируются — вручную писать такие пайплайны нецелесообразно, для этого существуют ETL/ELT-инструменты и оркестраторы вроде Apache Airflow.
- Анализ. На последнем этапе аналитики и алгоритмы машинного обучения строят отчёты, дашборды и предсказательные модели.
Каждый этап может стать узким местом: если сбор данных настроен без учёта дедупликации, всю последующую аналитику придётся пересчитывать заново. Поэтому конвейер проектируют целиком, а не по частям — это одна из задач, которую закрывает data engineering.
Инструменты и технологии для работы с биг-дата
Инструментарий подбирается под этап конвейера и объём данных — универсального решения «на всё» не существует.
| Задача | Инструменты | Когда применяют |
|---|---|---|
| Распределённая обработка | Hadoop, Apache Spark | Пакетная обработка петабайтов исторических данных |
| Потоковая передача | Apache Kafka, RabbitMQ | События в реальном времени: клики, платежи, IoT |
| Хранение неструктурированных данных | MongoDB, Cassandra, S3 | Логи, документы, медиафайлы без жёсткой схемы |
| Аналитическое хранилище | ClickHouse, BigQuery, Snowflake | Быстрые агрегирующие запросы по большим таблицам |
| Визуализация и BI | Power BI, Tableau, DataLens, Superset | Дашборды для бизнес-пользователей без SQL |
Для большинства продуктовых команд не нужно осваивать весь стек сразу — на старте достаточно наладить сбор событий и одно аналитическое хранилище, а BI-дашборды подключаются уже поверх готовых данных.
Как биг-дата и аналитика улучшают программное обеспечение?
- Оптимизация производительности
Одним из ключевых применений аналитики данных в разработке ПО является оптимизация производительности. Анализ больших объемов данных позволяет выявлять узкие места в коде, неэффективные алгоритмы и процессы, которые замедляют работу приложения. С помощью инструментов мониторинга и аналитики разработчики могут точно определить проблемные участки и внести необходимые изменения. - Понимание пользовательского опыта
Биг-дата предоставляет бесценную информацию о поведении пользователей. Анализируя информацию о том, как пользователи взаимодействуют с ПО, можно выявить популярные функции, часто встречающиеся проблемы и предпочтения аудитории. Эти знания позволяют улучшать интерфейс, добавлять востребованные функции и устранять неудобства, что повышает общий уровень удовлетворенности пользователей. - Предсказательная аналитика и предотвращение проблем
С помощью предсказательной аналитики можно прогнозировать потенциальные проблемы и предотвращать их до того, как они возникнут. Модели машинного обучения, обученные на исторических данных, могут предсказать сбои, ошибки и другие неполадки. Это позволяет разработчикам заранее принимать меры по их устранению, что значительно снижает затраты на поддержку и улучшает стабильность ПО. - Персонализация и адаптация
Анализ больших данных позволяет создавать персонализированные и адаптируемые программные продукты. Исследуя предпочтения и поведение пользователей, разработчики могут создавать индивидуальные предложения и адаптировать функциональность под конкретного пользователя. Это особенно важно для мобильных приложений, веб-сайтов и других платформ, где пользовательский опыт играет ключевую роль. - Улучшение процесса разработки
Биг-дата и аналитика могут оптимизировать сам процесс разработки программного обеспечения. Анализируя производительность команд, временных затратат на различные этапы разработки и качестве кода, можно выявить лучшие практики и методы работы. Это способствует повышению эффективности команд, сокращению сроков разработки и улучшению качества конечного продукта.
Практические примеры использования биг-дата и аналитики
- Netflix
Один из самых известных примеров использования биг-дата и аналитики – это Netflix. Компания анализирует просмотры, предпочтения юзеров и их взаимодействия с платформой, чтобы рекомендовать фильмы и сериалы, которые могут быть интересны конкретному зрителю. Это значительно повышает удовлетворенность пользователей и удержание аудитории. - Uber
Uber использует биг-дата для оптимизации своих сервисов. Исследование поездок, маршрутов, времени ожидания и отзывов клиентов помогает компании улучшать качество обслуживания, предлагать более выгодные тарифы и оптимизировать маршруты. - Airbnb
Airbnb - бронирования, цены, отзывы и предпочтения пользователей, чтобы рекомендовать лучшие варианты жилья и устанавливать оптимальные цены. Это помогает компании привлекать больше клиентов и обеспечивать высокий уровень сервиса.
В каких отраслях применяется биг-дата
Примеры Netflix, Uber и Airbnb показывают логику применения, но биг-дата так же плотно встроена в отрасли, далёкие от потребительских приложений.
| Отрасль | Задача | Эффект |
|---|---|---|
| Банки и финтех | Скоринг, антифрод в реальном времени | Решение по заявке за секунды вместо дней |
| Ритейл и e-commerce | Персонализация выдачи, прогноз спроса | Меньше неликвида на складе, выше конверсия |
| Медицина | Анализ снимков и историй болезни | Раннее выявление патологий |
| Логистика | Оптимизация маршрутов и складских запасов | Снижение затрат на топливо и хранение |
| Производство | Предиктивное обслуживание оборудования | Меньше простоев из-за поломок |
Биг-дата в России
Российский рынок big data растёт вместе с импортозамещением инфраструктуры: компании переходят с зарубежных облаков на Yandex Cloud, VK Cloud и локальные DWH на базе ClickHouse — этот инструмент изначально разработан в Яндексе и остаётся одним из самых быстрых open-source решений для аналитических запросов. Спрос выше всего в банках, телекоме, ритейле и e-commerce — именно там больше всего транзакционных и поведенческих данных, а конкуренция заставляет использовать их быстрее конкурентов.
Для среднего бизнеса порог входа ниже, чем кажется: не обязательно строить дата-платформу федерального банка — часто достаточно настроить сбор событий, одно облачное хранилище и несколько дашбордов, чтобы принимать решения на основе цифр, а не интуиции.
Кто работает с биг-дата в команде разработки
Задачи из конвейера выше редко закрывает один универсальный специалист — обычно это несколько ролей, которые подключаются на разных этапах.
- Data engineer — строит и поддерживает пайплайны сбора и хранения данных, отвечает за то, чтобы данные доходили до аналитика чистыми и вовремя.
- Data scientist / ML-инженер — строит предсказательные модели: прогноз оттока, рекомендации, детекцию аномалий.
- BI-аналитик — переводит сырые метрики в дашборды и отчёты, понятные бизнесу без SQL.
- Backend-разработчик — встраивает результаты аналитики обратно в продукт: рекомендации, персонализацию, алерты.
Нанимать все четыре роли в штат ради одного проекта нерентабельно, особенно на старте, поэтому чаще привлекают выделенную команду под конкретную задачу — от разовой настройки дашборда до постоянного сопровождения дата-платформы.
Вызовы и перспективы
По разным оценкам, к 2027 году объём генерируемых в мире данных превысит 180 зеттабайт — и без выстроенных процессов эта масса становится не активом, а балластом.
Несмотря на все преимущества, работа связана с рядом вызовов. Среди них можно выделить:
- Защита и конфиденциальность
Обработка больших объемов информации требует особого внимания к вопросам безопасности и конфиденциальности. Нарушение этих аспектов может привести к серьезным последствиям, включая потерю доверия клиентов и юридические проблемы. - Необходимость в квалифицированных специалистах
Работа с биг-датой требует глубоких знаний в области аналитики, статистики и программирования. Найти квалифицированных специалистов может быть непросто, особенно с учетом постоянно растущего спроса на таких профессионалов. - Инфраструктура и ресурсы
Обработка и хранение больших объемов требует значительных вычислительных ресурсов и специализированной инфраструктуры. Компании должны быть готовы инвестировать в создание и поддержку таких систем.
Тем не менее, перспективы использования биг-дата и аналитики в разработке ПО весьма обнадеживающие. Постоянное развитие технологий машинного обучения, искусственного интеллекта и облачных вычислений открывает новые возможности для анализа и использования биг-дата. Компании, которые смогут эффективно интегрировать это в свои процессы, получат значительные конкурентные преимущества и смогут создавать высококачественные ПО, отвечающие потребностям современных юзеров.
Заключение
Биг-дата и аналитика – мощные инструменты, которые могут значительно улучшить программное обеспечение. От оптимизации производительности и персонализации до предсказательной аналитики и улучшения процесса разработки – открывают множество возможностей для разработчиков и компаний. Несмотря на вызовы, связанные с работой с большими объемами, перспективы их использования весьма обнадеживающие. В будущем это станет неотъемлемой частью разработки ПО, помогая создавать инновационные и востребованные решения.
Аналитика данных и BI в YuSMP Group — рабочая альтернатива, если нужно не просто разобраться в теме, а получить готовый дашборд или пайплайн под конкретную задачу. Проекты, которые мы создали, показывают, как аналитика отражается на реальных продуктах.
Частые вопросы
Что такое биг-дата простыми словами?
Биг-дата — это данные настолько большого объёма, разнообразия и скорости поступления, что их невозможно обработать в обычной реляционной базе данных или Excel: нужны распределённые системы вроде Hadoop или Spark и отдельная инфраструктура хранения.
Чем биг-дата отличается от обычной базы данных?
Обычная база данных рассчитана на структурированные записи фиксированного объёма и обрабатывается на одном сервере. Биг-дата включает ещё и неструктурированные данные — текст, видео, логи, измеряется в терабайтах и петабайтах и обрабатывается распределённо, на кластере серверов.
С чего начать работу с большими данными небольшой компании?
Начните не с покупки инфраструктуры, а с постановки цели: какое решение вы хотите принимать на основе данных. Дальше наладьте сбор нужных событий, разместите их в одном облачном хранилище и постройте первый дашборд — расширять стек имеет смысл только тогда, когда текущего решения перестаёт хватать.
Какие профессии связаны с биг-дата?
Основные роли — data engineer (строит пайплайны сбора и хранения), data scientist и ML-инженер (строят предсказательные модели), BI-аналитик (готовит отчёты и дашборды). В небольших командах эти роли часто совмещает один специалист.
Сколько стоит внедрение аналитики больших данных для среднего проекта?
Стоимость зависит от того, есть ли уже инфраструктура сбора данных: точечная настройка дашборда на готовых данных обходится в разы дешевле, чем построение дата-платформы с нуля. Точную оценку даёт технический аудит текущих источников данных.
Заменит ли ИИ аналитиков данных?
Нет — модели машинного обучения автоматизируют рутинные расчёты и находят закономерности, но постановка задачи, проверка данных на корректность и интерпретация результатов для бизнеса по-прежнему требуют участия человека.
Превратим данные в решения
BI-дашборды и аналитика — увидите бизнес в цифрах.